Google расширила семейство нейросетей Gemini двумя моделями для синтеза речи – Gemini 3.8 Flash TTS и Gemini 3.8 Flash-Lite TTS. Первая модель ориентирована на выразительную озвучку и точную настройку голоса, вторая – на быструю обработку большого количества текста.
Обновление интересно не только разработчикам голосовых сервисов. Практический пример показал автор DEV Community Эван Лин: он использовал новую модель при создании приложения для изучения японского языка с помощью музыкальных видеозаписей.
Gemini получила новый синтез речи с управлением голосом
Главное изменение – возможность не просто выбирать готовый голос, а создавать его по текстовому описанию. Можно задать возрастной характер звучания, акцент, эмоциональную подачу и манеру речи. Google также открыла библиотеку более чем из 2000 подготовленных голосов и заявила поддержку свыше 100 языков и диалектов.
Отдельными указаниями можно управлять каждой репликой: менять скорость произношения, настроение, паузы и интонацию. Модель поддерживает сцены с двумя говорящими и способна сохранять характер выбранного голоса при продолжительной озвучке.
Озвучка текста нейросетью подходит для изучения иностранных языков
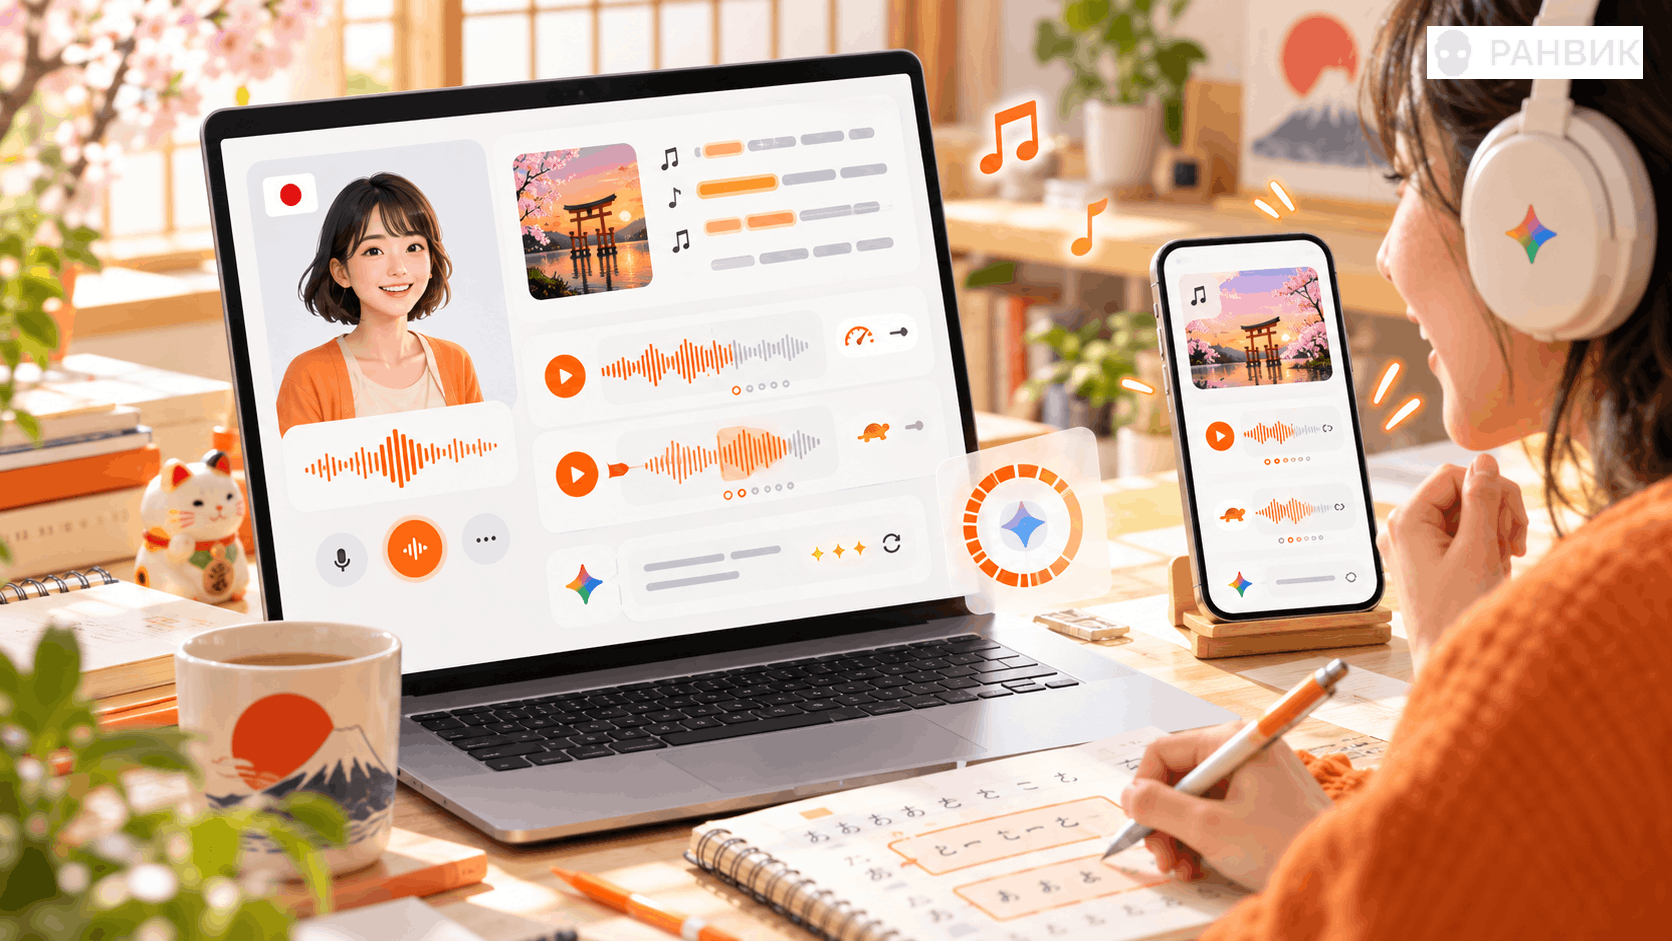
Автор практического опыта применил Gemini 3.8 Flash TTS как виртуального преподавателя японского языка. Система разбирала строки песни, формировала произношение и создавала две версии озвучки – обычную и замедленную.
Такой подход показывает полезный сценарий использования генерации голоса нейросетью. Вместо простой функции чтения текста можно создать персонального помощника, который произносит фразы медленнее, выделяет сложные места и сохраняет одинаковую манеру речи на протяжении всего урока.
Генерация голоса нейросетью от Gemini стала полезнее для реальных проектов
Gemini 3.8 Flash TTS можно применять не только для обучения языкам. Модель подходит для аудиокниг, озвучки роликов, голосовых помощников, игровых персонажей и диалоговых сцен. Для воспроизведения существующего голоса Google Gemini создаваемое системой аудио получает специальную цифровую отметку.
Практический запуск показывает важную тенденцию: синтез речи постепенно превращается из обычного чтения текста в инструмент управления полноценной голосовой сценой.
Экспертный вывод
Gemini 3.8 Flash TTS интересна прежде всего точным управлением подачей каждой фразы. Это особенно полезно для обучения, длинной озвучки и проектов, где голос должен оставаться узнаваемым.
Рекомендация: сначала проверять модель на небольшом наборе типовых фраз, отдельно оценивать произношение имен и специальных терминов и заранее учитывать ограничения по числу запросов. Такой подход позволит понять реальное качество системы до масштабирования проекта.
